Sitemap.xml w Shoper - do czego służy?
Sitemap.xml to plik zawierający adresy podstron sklepu, które mogą być odwiedzane przez roboty wyszukiwarki. W przypadku e-commerce są to przede wszystkim adresy produktów, kategorii oraz innych istotnych części serwisu.
Mapa pomaga Google sprawniej poznawać strukturę sklepu. Jest to szczególnie istotne przy dużym asortymencie, gdzie liczba adresów URL może sięgać tysięcy.
Trzeba jednak pamiętać, że obecność strony w sitemapie nie oznacza automatycznie jej indeksacji. Mapa jest dla Google wskazówką, a nie poleceniem umieszczenia każdego adresu w wynikach wyszukiwania.
Czy Shoper automatycznie tworzy sitemap.xml?
Tak. Shoper standardowo generuje własną mapę witryny, więc w większości sklepów nie ma potrzeby przygotowywania osobnego pliku XML.
Adres standardowej mapy może wyglądać następująco:
https://www.domena.pl/console/integration/execute/name/GoogleSitemap
Taką lokalizację wskazuje również dokumentacja dotycząca konfiguracji sklepów na platformie Shoper.
To rozwiązanie jest wygodne, ponieważ wraz ze zmianami w sklepie nie trzeba ręcznie dopisywać kolejnych produktów czy kategorii do pliku. Sitemap jest obsługiwana przez mechanizmy platformy.
Sama mapa jest jednak tylko jednym z technicznych elementów, które warto sprawdzić, prowadzącpozycjonowanie na Shoper.
Gdzie znaleźć sitemap.xml w panelu Shoper?
Nie trzeba wpisywać adresu mapy ręcznie. Można znaleźć go bezpośrednio w panelu administracyjnym Shopera.
W zależności od wersji panelu sekcja może znajdować się w ustawieniach związanych z SEO lub pozycjonowaniem. W starszym układzie panelu ścieżka prowadzi przez:
Ustawienia → Zaawansowane → SEO → Google Sitemap.
W tej sekcji można sprawdzić adres wygenerowanej przez system mapy.
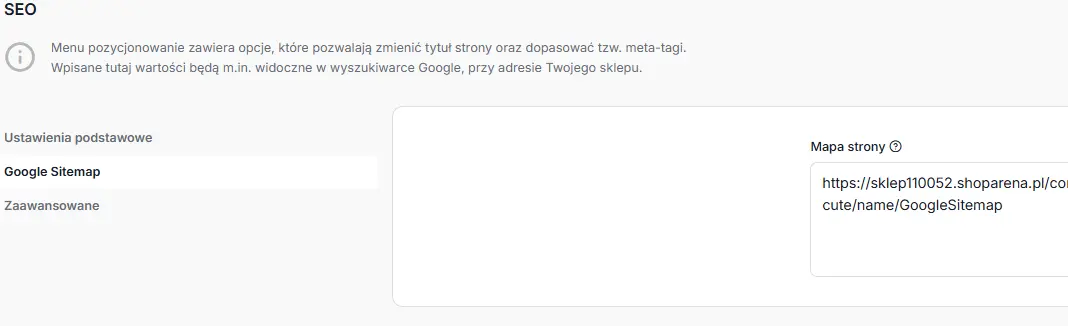
Jeżeli menu w Twoim sklepie wygląda nieco inaczej, najlepiej odszukać w ustawieniach sekcję Google Sitemap lub ustawienia SEO. Shoper na przestrzeni lat zmieniał wygląd i nazewnictwo części panelu.
Po znalezieniu linku warto po prostu otworzyć go w nowej karcie przeglądarki. Jeżeli wyświetli się dokument XML z adresami sklepu, mapa jest dostępna.
Co zawiera sitemap.xml w sklepie Shoper?
Mapa witryny Shopera przekazuje Google adresy istotnych podstron znajdujących się w sklepie. W zależności od konfiguracji serwisu mogą być to między innymi:
- karty produktów,
- strony kategorii,
- strony producentów,
- wpisy blogowe,
- strony informacyjne.
Nie należy jednak zakładać, że każdy adres technicznie istniejący w sklepie powinien trafić do mapy i do indeksu Google. Shoper może generować dodatkowe warianty adresów związane między innymi z filtrowaniem, sortowaniem czy paginacją. Część takich URL-i nie powinna być indeksowana.
Dlatego podczasaudytu SEO sklepu internetowego warto sprawdzić nie tylko, czy mapa istnieje, lecz także czy najważniejsze podstrony sklepu są dostępne dla Google i czy platforma nie generuje niepotrzebnych adresów mogących powodować problemy z indeksacją.
Jak odświeżyć mapę strony w Shoperze?
Standardowo sitemap jest obsługiwana przez Shopera automatycznie. W materiałach dotyczących konfiguracji platformy wskazano również prosty sposób wymuszenia ponownego wygenerowania mapy: można edytować nazwę jednego z produktów, np. dodać i następnie usunąć spację.
Nie ma potrzeby wykonywania takiej operacji po każdej zmianie w sklepie. Może być jednak pomocna, gdy po większej aktualizacji asortymentu chcemy sprawdzić, czy mapa została ponownie wygenerowana.
Jak zgłosić sitemap.xml z Shopera do Google Search Console?
Po znalezieniu adresu mapy pozostaje przesłać go do Google Search Console. Cała operacja jest prosta.
Najpierw zaloguj się do Google Search Console i wybierz usługę odpowiadającą domenie sklepu. Następnie przejdź do sekcji Mapy witryn.
W polu przeznaczonym do dodania nowej mapy wpisz ścieżkę prowadzącą do sitemap Shopera, np.:
console/integration/execute/name/GoogleSitemap
i kliknij Prześlij.
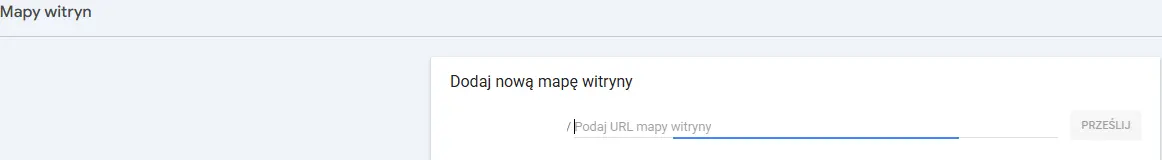
Google spróbuje pobrać mapę oraz znajdujące się w niej adresy. Po przetworzeniu pliku w Google Search Console pojawi się jego status.
Jeżeli wszystko działa prawidłowo, nie trzeba ponownie przesyłać mapy po każdym dodaniu produktu. Adres sitemapy pozostaje taki sam, a Google może regularnie do niego wracać i sprawdzać zmiany.
Co sprawdzić po dodaniu mapy Shopera do Google?
Po zgłoszeniu sitemap.xml warto po pewnym czasie wrócić do Google Search Console i upewnić się, że Google może ją prawidłowo odczytać.
Jeżeli pojawia się błąd, najpierw otwórz adres mapy bezpośrednio w przeglądarce. Następnie sprawdź, czy korzystasz z właściwej wersji domeny, np. z HTTPS oraz prawidłowym wariantem z www lub bez www.
Status poprawnie odczytanej mapy również nie oznacza, że wszystkie znajdujące się w niej produkty zostały zaindeksowane. Jeżeli istotne kategorie lub karty produktów długo nie pojawiają się w Google, trzeba szukać przyczyny szerzej: w ustawieniach indeksowania, linkowaniu wewnętrznym, tagach canonical, robots.txt lub jakości samych podstron.
Właśnie dlatego sitemap.xml należy traktować jako jeden z elementów technicznegopozycjonowania sklepów internetowych, a nie rozwiązanie wszystkich problemów z widocznością.
Czy w Shoperze można dodać własną sitemap.xml?
Tak, choć w większości sklepów nie będzie to potrzebne. Shoper pozwala wgrać własny plik mapy poprzez zarządzanie plikami. Jeżeli plik sitemap.xml zostanie umieszczony w głównym katalogu upload, może być dostępny np. pod adresem:
https://www.domena.pl/upload/sitemap.xml
Taką możliwość opisują również materiały dotyczące bardziej zaawansowanej konfiguracji Shopera.
W standardowej sytuacji lepiej jednak korzystać z mapy generowanej automatycznie przez platformę. Własna sitemap ma sens przede wszystkim wtedy, gdy istnieje konkretny problem techniczny lub sklep wymaga niestandardowej konfiguracji.
Robots.txt w Shoper - jak edytować plik i czego nie blokować?
Plik robots.txt w Shoperze pozwala określić, do których części sklepu roboty wyszukiwarek mogą uzyskiwać dostęp. Jego edycja jest prosta, ale jedna zbyt szeroka reguła może przypadkowo zablokować Google ważne kategorie, produkty czy inne podstrony. Dlatego robots.txt warto zmieniać tylko wtedy, gdy wiadomo, jaki problem ma rozwiązać.
Robots.txt jest plikiem tekstowym dostępnym standardowo pod adresem:
https://twojadomena.pl/robots.txt
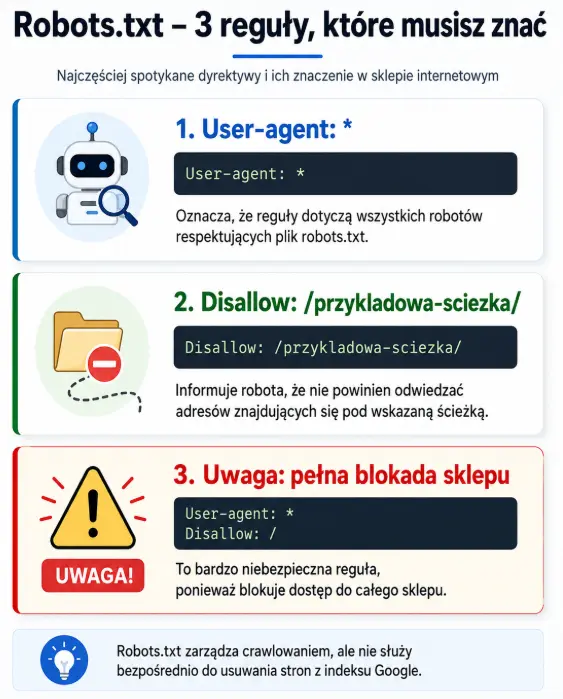
Służy przede wszystkim do sterowania crawlowaniem sklepu, czyli określania, które adresy robot wyszukiwarki może odwiedzać. Nie należy traktować go jako narzędzia do usuwania stron z indeksu Google.
Jeżeli chcesz szerzej poznać techniczne możliwości platformy, sprawdź również materiał opozycjonowaniu na Shoper.
Gdzie edytować robots.txt w Shoperze?
W panelu administracyjnym Shoper plik robots.txt można edytować w ustawieniach SEO. Przed wprowadzeniem zmian warto najpierw otworzyć obecny plik pod adresem domena.pl/robots.txt i zapisać jego zawartość.
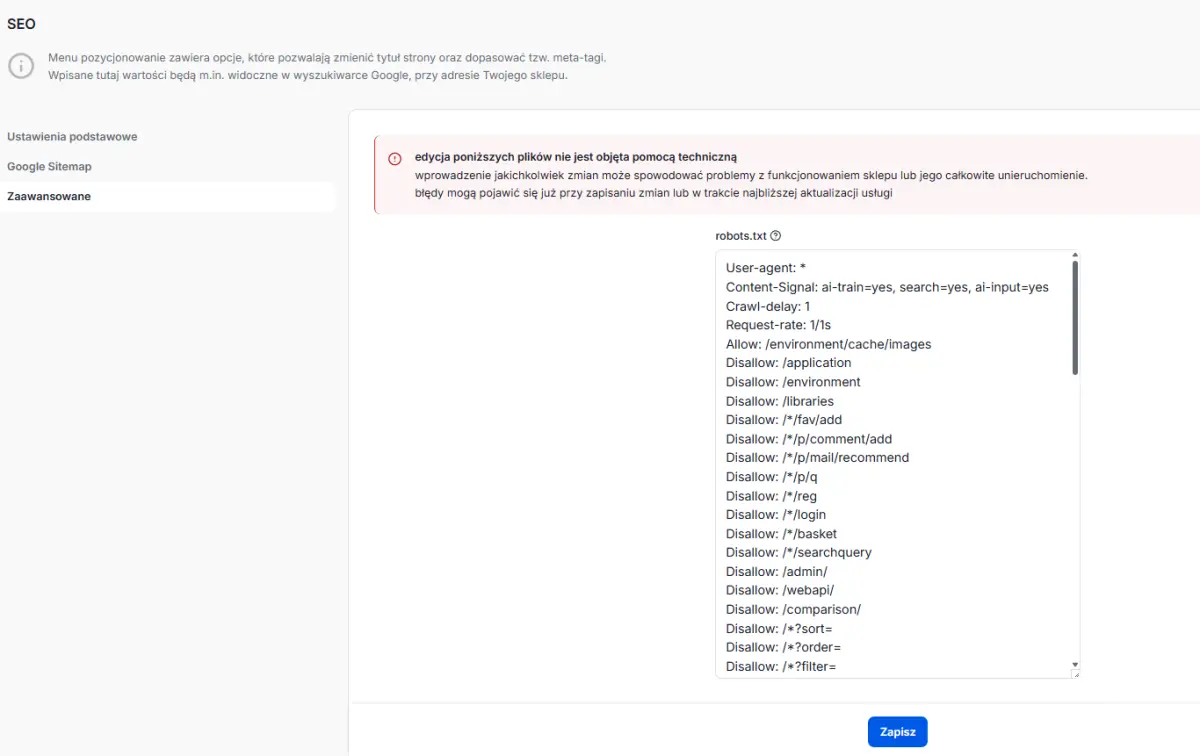
Shoper domyślnie posiada już reguły ograniczające robotom dostęp do części technicznych sklepu. Nie warto więc usuwać całej konfiguracji i tworzyć jej od początku. Bezpieczniej jest dodawać wyłącznie reguły rozwiązujące konkretny, wcześniej sprawdzony problem.
Jak działają reguły w robots.txt?
Jak edytować robots.txt w Shoperze?
Przed zmianą najlepiej wykonać kopię obecnego pliku. Następnie dodaj tylko regułę dotyczącą adresów, które zostały wcześniej sprawdzone.
Po zapisaniu zmian ponownie otwórz domena.pl/robots.txt i upewnij się, że nowa konfiguracja jest widoczna. Następnie sprawdź kilka adresów, które miały zostać zablokowane, ale również najważniejsze strony sklepu: stronę główną, kategorie, produkty, producentów i blog.
Przy większych zmianach warto skontrolować sklep również w Google Search Console lub wykonaćaudyt SEO sklepu internetowego.
Co można blokować w robots.txt w Shoperze?
Robots.txt może być przydatny w przypadku technicznych i powtarzalnych adresów, które nie powinny być regularnie crawlowane.
Jednym z problemów występujących w części sklepów Shoper są dodatkowe warianty strony głównej, np. /pl/index/2 czy /pl/index/phot. Shoper może wyświetlać zawartość strony głównej również pod adresami pasującymi do schematu /pl/index/*.
Jeżeli analiza sklepu potwierdzi, że są to wyłącznie niepotrzebne duplikaty, można rozważyć regułę:
Disallow: /*/index
Nie należy jednak kopiować jej automatycznie do każdego sklepu. Najpierw trzeba sprawdzić, jakie adresy rzeczywiście obejmie.
W Shoperze warto również zwracać uwagę na inne małowartościowe podstrony oraz techniczne warianty URL, które można znaleźć podczas analizy indeksacji.
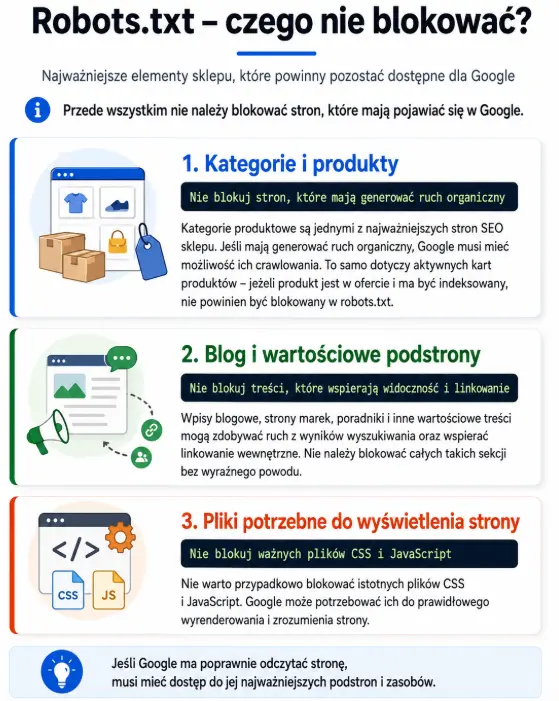
Czego nie blokować w robots.txt?
Czy blokować filtry i sortowania w Shoperze?
Nie zawsze.
Filtry i sortowania mogą generować bardzo dużo adresów URL, ale sposób ich obsługi powinien wynikać z analizy konkretnego sklepu. Część kombinacji może być całkowicie zbędna, natomiast inne mogą odpowiadać na realne zapytania użytkowników.
Dlatego nie należy automatycznie blokować wszystkich filtrów w robots.txt. W zależności od sytuacji lepszym rozwiązaniem może być noindex, canonical lub pozostawienie części adresów dostępnych dla Google.
Czy blokować paginację?
Także w tym przypadku trzeba zachować ostrożność.
Kolejne strony kategorii mogą pomagać robotom dotrzeć do produktów znajdujących się głębiej w strukturze sklepu. Zablokowanie wszystkich adresów /2, /3, /4 itd. może więc utrudnić crawlowanie asortymentu.
Sama obecność paginacji nie jest problemem. Znaczenie ma przede wszystkim sposób jej indeksowania, linkowania i ustawienia tagów canonical.
Robots.txt a noindex - to nie jest to samo
Robots.txt mówi robotowi, czy może wejść na określony adres. Noindex informuje natomiast, że dana strona nie powinna pojawiać się w indeksie.
Jeżeli strona ma ustawiony noindex, a jednocześnie zostanie zablokowana w robots.txt, Google może nie mieć możliwości wejścia na nią i odczytania tagu noindex.
Dlatego robots.txt nie powinien być automatycznie używany do usuwania stron z Google.
Jak sprawdzić robots.txt po zmianach?
Po zapisaniu nowej konfiguracji sprawdź przede wszystkim, czy Google nadal może odwiedzać:
- stronę główną,
- główne kategorie,
- produkty,
- strony producentów,
- wpisy blogowe.
Jeżeli dodana reguła dotyczy konkretnego wzorca URL, przetestuj zarówno adres, który powinien zostać zablokowany, jak i podobny adres, który musi pozostać dostępny.
Przypozycjonowaniu sklepów internetowych robots.txt powinien być analizowany razem z Google Search Console, tagami noindex, canonicalami, mapą witryny i strukturą linkowania.
Edycja robots.txt w Shoperze nie jest skomplikowana. Najważniejsze jest jednak to, aby nie blokować stron tylko dlatego, że dany URL wygląda niepotrzebnie.
Chcesz rozwinąć blog w Shoper pod Google i AI?
Pomożemy zaplanować strukturę treści, kategorie i linkowanie do oferty. Skontaktuj się z nami